Seagate'te, mühendislik ekiplerimiz ve ben düzenli olarak dünyanın en büyük bulut ve yapay zeka altyapı geliştiricileriyle bir araya geliyoruz.
Onlara eksabaytlarca yüksek kapasiteli sabit disk sağlamanın yanı sıra, depolama mimarilerini şekillendirmelerine yardımcı olmak için de birlikte çalışıyoruz.
Bu ortaklıklar sayesinde, büyük ölçekli depolama kararlarının nasıl alındığına dair birinci elden bilgi sahibi oldum. Ortak nokta açık: Performansı, verimliliği ve verinin değerini en üst düzeye çıkarmak için ekonomi, yazılım düzenlemesi ve donanım yetenekleri uyumlu olmalıdır.
Yapay zekâ iş yükleri, veri kümesi boyutlarını, erişim sıklığını, bağlam pencerelerini, paralelliği, saklama süresini ve paylaşımlı depolama sistemlerine yönelik talepleri artırmaya devam ettikçe, bu uyum daha da önem kazanmıştır.
Ölçekteki bu değişimler, "birincil depolama"nın anlamını temelden değiştirdi.
Tarihsel olarak, birincil depolama, işlem birimine yakın konumlandırılmış, birbirine sıkıca bağlı blok veya dosya sistemlerini ifade ediyordu. Ancak bulut ve yapay zeka ortamlarında, birincil depolama giderek artan bir şekilde, nesne depolamayı, iş yükleri genelinde büyük veri hacimlerini saklayan ve sunan kalıcı bir kayıt sistemi olarak ele alan, yazılım tanımlı, küresel olarak dağıtılmış mimariler tarafından belirlenmektedir.
Bu yeniden tanımlamanın nasıl gerçekleştiğini daha iyi anlamak için, kurumsal depolamayı başlangıçta şekillendiren tasarım prensiplerini inceleyelim.
Ölçeklendirme Depolama Paradigmasını Nasıl Değiştirdi?
On yıllarca ekosistem ortak bir standart altında faaliyet gösterdi: Taşınabilir İşletim Sistemi Arayüzü (POSIX). Daha yerelleştirilmiş altyapının olduğu bir dönemde tasarlanan POSIX, geliştiricilere verilerle etkileşim kurmak için öngörülebilir bir model sağladı.
Güçlü yazma sonrası okuma tutarlılığına, senkronize dosya kilitlemeye ve hiyerarşik dizin yapılarına önem verdi. Tek bir makine veya yerelleştirilmiş bir küme için son derece etkiliydi ve bugün de birçok kurumsal ve uygulama ortamı için kritik önem taşımaya devam ediyor.
Ancak bulut modeli ortaya çıktığında, belirleyici dengeler değişti. Bulut ölçekli sistemler, POSIX öncelikli sistemlerin başlangıçta hizmet etmek üzere tasarlandığı ölçek, dağıtım modeli ve maliyet yapısından temelde farklı bir ölçek, dağıtım modeli ve maliyet yapısı için inşa edilmiştir.
Dağıtılmış bir ortamda, POSIX tarzı uygulamalar, dizin semantiğini, dosya kilitlemeyi ve yerinde güncellemeleri korumak için düğümler arasında önemli bir düzenleme gerektirebilir.
Bulut platformlarının devasa ölçeklere ihtiyacı vardı; sonunda onlarca hatta yüzlerce eksabaytı destekleyecek şekilde genişlediler ve bu ortamda, sıkıca bağlantılı tasarımların koordinasyon yükü gecikmelere yol açmaya ve büyümeye pratik sınırlar koymaya başladı.
Daha büyük veri kümeleri, kontrol noktası oluşturma, belirteç işleme, çıkarım ve yüksek oranda paralel veri işlem hatları gerektiren modern yapay zeka iş yüklerinde bu baskılar daha da arttı.
Sektör genelinde, Google Cloud Storage (GCS) ve Colossus'tan Microsoft Azure Blob, Amazon S3 ve Meta'nın Tectonic'ine kadar bulut platformları, küresel olarak dağıtılmış veriler ve hiper ölçekli iş yükleri için özel olarak tasarlanmış yazılım tanımlı mimarileri benimsedi ve ölçek ve gereksinimler geliştikçe bunları zaman içinde iyileştirdi.
Bu yeni paradigmada, yazılım, düzenleme, dayanıklılık ve veri akışı konusunda daha fazla sorumluluk üstlenerek, temel depolama ortamlarının mümkün olduğunca verimli kullanılmasını sağlar.
Sabit Diskler Büyük Ölçekli Depolamayı Destekliyor
Yukarıda bahsettiğim bulut mimarilerinde, sabit diskler büyük ölçekte veri depolamanın temelini oluşturur.
Bu durum, kapasite ekonomisinin ve yüksek yoğunluklu kayıtın fiziksel gerçekliğinin kalıcılığını yansıtmaktadır. Modern yüksek kapasiteli sabit diskler, alan yoğunluğunu artırmaya devam etmek ve eksabayt ölçekli depolamayı mümkün kılmak için Shingled Magnetic Recording (SMR) ve Heat-Assisted Magnetic Recording (HAMR) gibi teknolojileri içermektedir.
Bu ölçekte, sabit disk filoları, dayanıklılık, maliyet verimliliği ve alternatif depolama teknolojilerinin asla ulaşamayacağı hacimsel yoğunluk sağlayarak kayıt sistemi görevi görür.
Büyük veri merkezlerindeki exabaytların %87'sinin sabit disklerde depolanmasının bir nedeni var1!
Bulut ortamları genişlemeye devam ettikçe ve yapay zeka iş yükleri daha büyük veri hacimlerini tüketip, üretip, saklayıp ve yeniden kullandıkça, bu avantajlar daha da önem kazanmaktadır.
Ancak bunlar, yazılım mimarisinin yüksek kapasiteli disklerin güçlü yönleriyle uyumlu olacak şekilde tasarlanması durumunda tam olarak gerçekleştirilebilir.
Geleneksel POSIX erişim kalıpları, özellikle parçalı, rastgele ve yerinde güncellemeleri vurgulayan sıkıca bağlı dağıtılmış dosya sistemi modellerinde, aşırı ölçekte bu güçlü yönlerle her zaman iyi bir uyum içinde değildir.
Modern yazılım tanımlı bulut platformları, depolama yığınlarını sabit diskler etrafında tasarlayarak bu sorunu çözdüler ve böylece ölçeklenebilir operasyonel ekonomiyi desteklerken sıralı, yüksek verimli veri akışlarına öncelik verebildiler.
500 trilyon nesneyi depolayan ve saniyede 200 milyon isteğe hizmet veren bir hizmet olan Amazon S3 örneğinde—yakın zamanda yapılan bir AWS re:Invent açılış konuşmasında2 , bulut depolama performansının sırrının, sunumda "mühendislik harikası" olarak tanımlanan sabit sürücünün yeteneklerini optimize eden yazılım yazmak olduğu vurgulandı.
Modern bulut mimarileri, farklı bir döneme ait yazılım soyutlamalarına uymaya zorlamak yerine, modern yüksek yoğunluklu sabit disklerin güçlü yönlerini tamamlayacak şekilde tasarlanmıştır.
Bulut Mimarileri Sabit Disk Verimliliğini Nasıl Artırıyor?
Bu mühendislik tasarımı çeşitli biçimler aldı, ancak önde gelen bulut platformlarında genel olarak dört mimari prensibi yansıtıyor. Birlikte ele alındığında, bu iki örnek, bulut depolamanın veri akışı, meta veriler, dayanıklılık ve veri alım davranışını yönetme biçiminde giderek daha çok yazılım odaklı hale geldiğini göstermektedir.
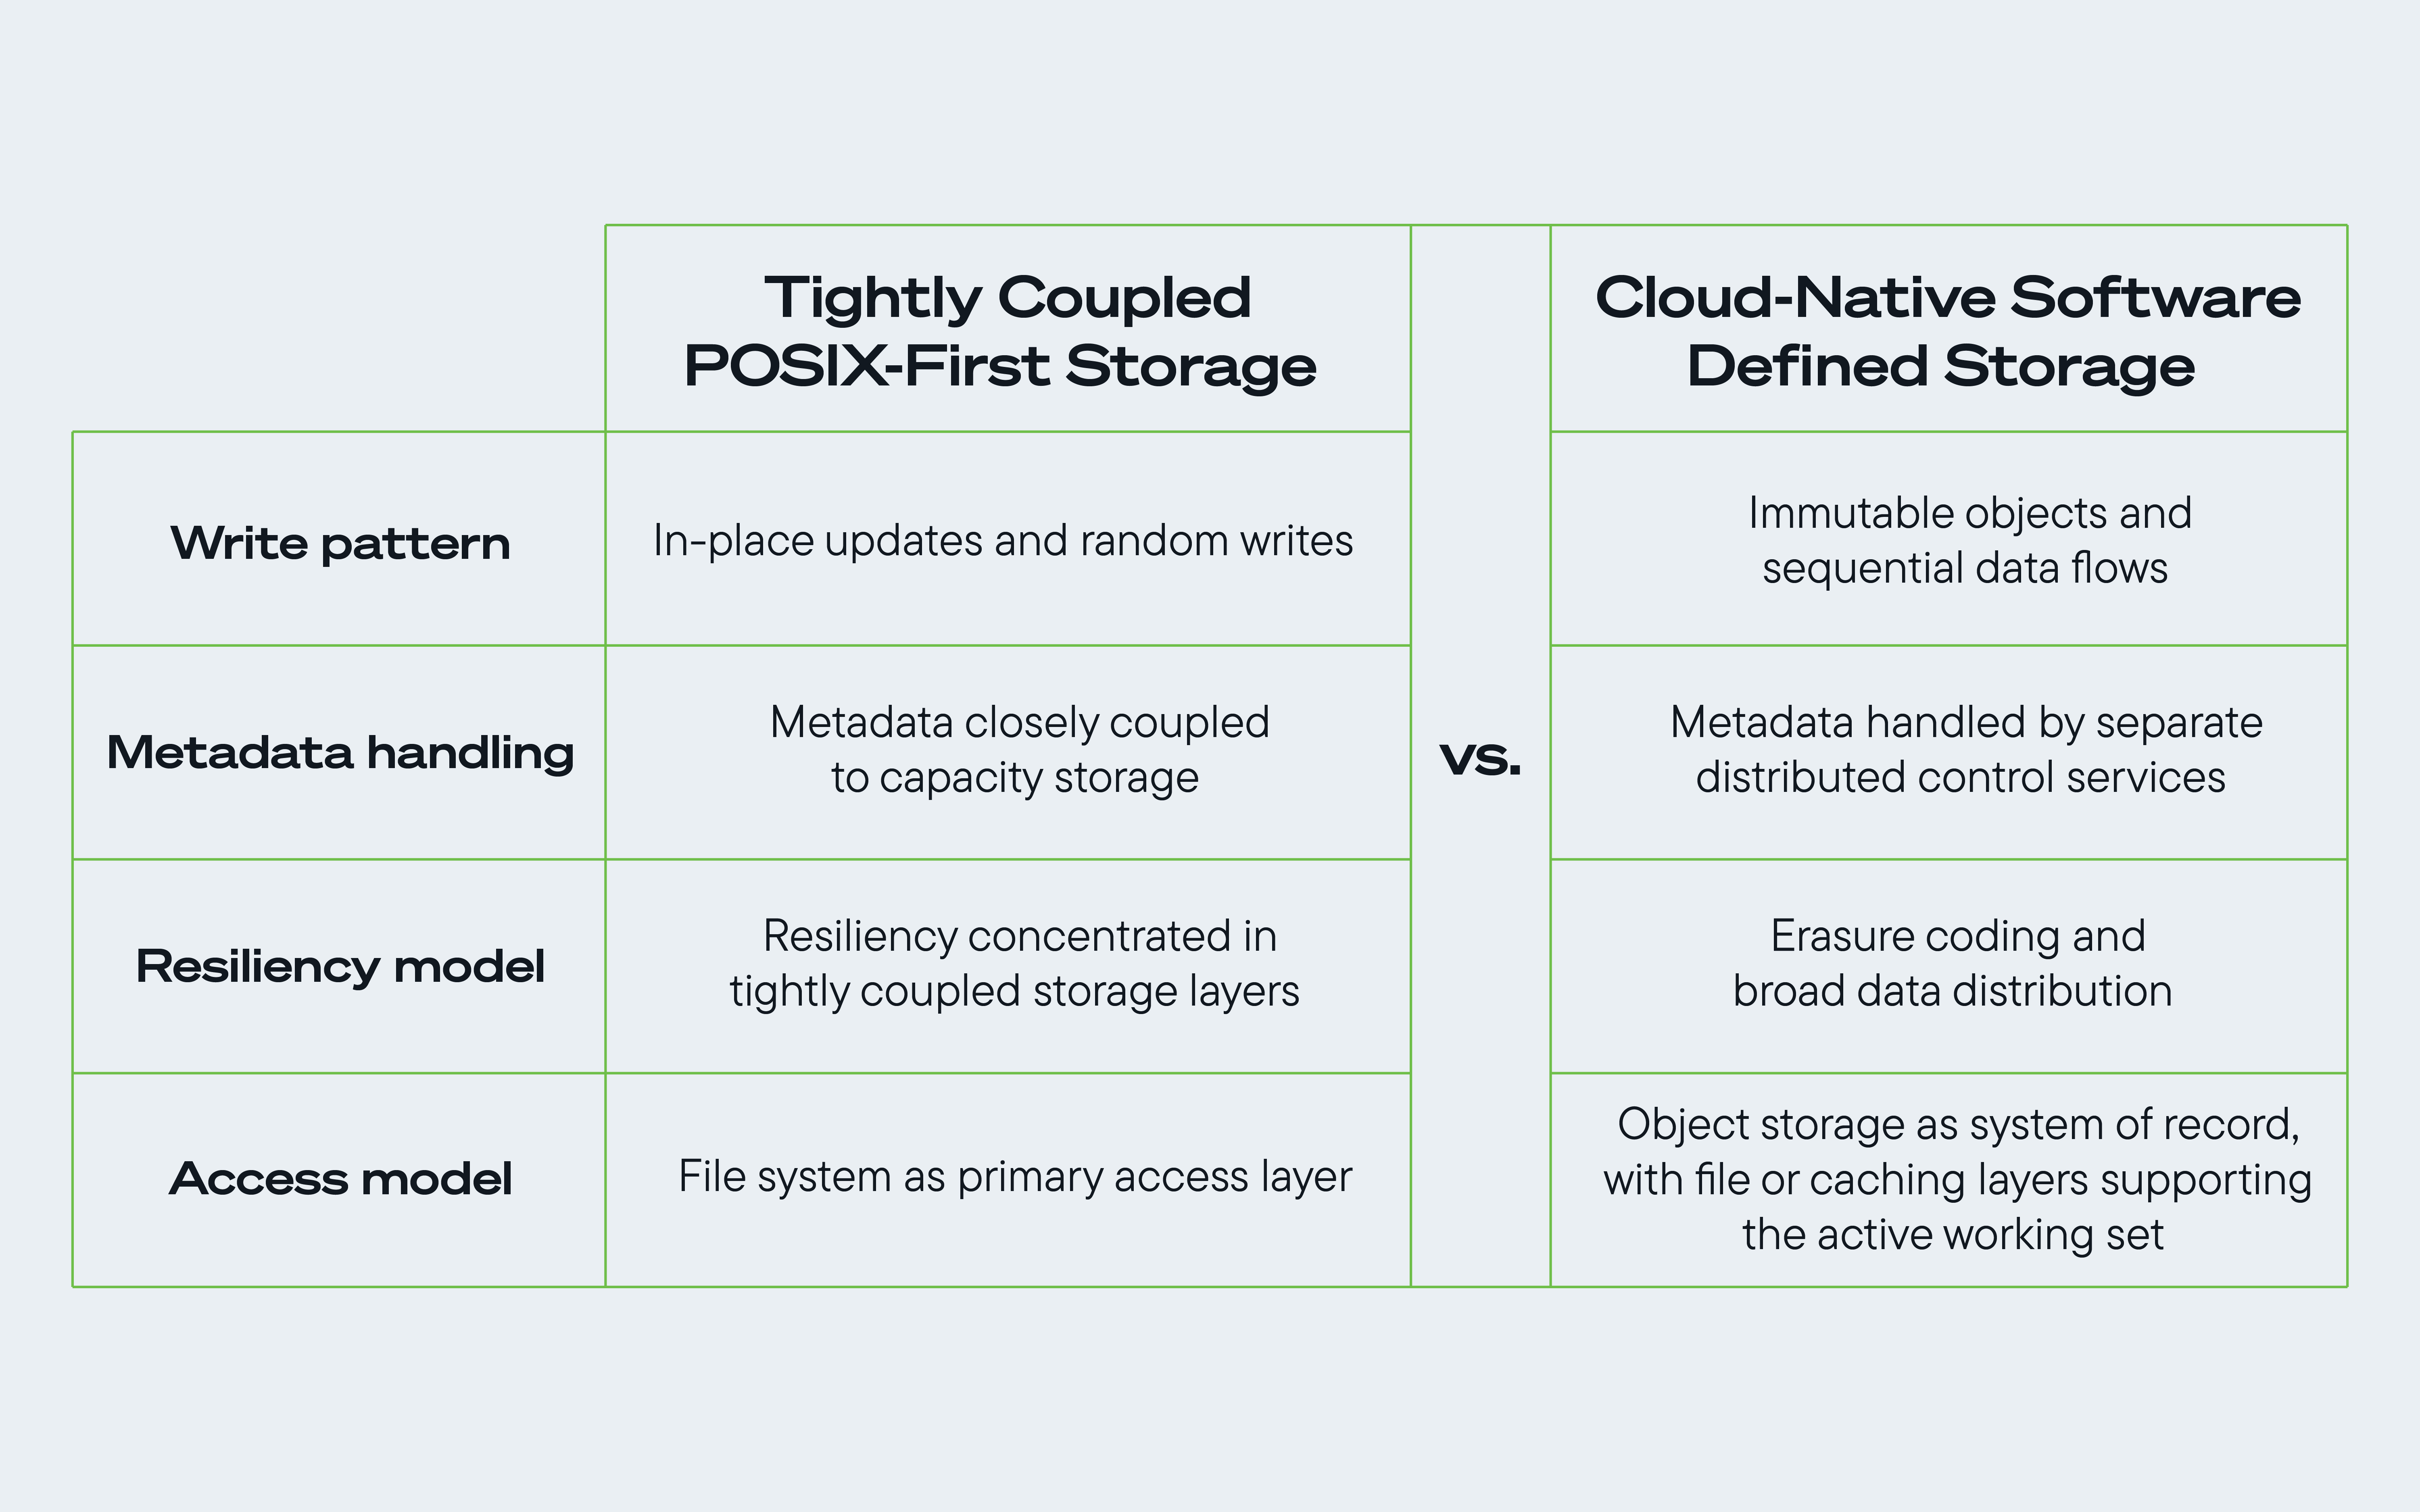
1. Nesnelerin Değişmezliği, Sıralı Veri Akışlarını Destekler
GCS ve Amazon S3 gibi hizmetler, nesnelerin değiştirilemezliğini ve sürümlü güncellemeleri desteklemek üzere tasarlanmıştır. Veriler bir nesne deposuna yazıldıktan sonra, güncellemeler genellikle mevcut olanı yerinde değiştirmek yerine nesnenin yeni bir sürümünü yazarak gerçekleştirilir.
Bulut ölçekli mimariler, rastgele ve yerinde ikili yazma ihtiyacını azaltarak diskin iş yükünün daha büyük bir bölümünü sıralı veri akışlarına kaydırır. Bu, yüksek kapasiteli sürücülerin büyük ölçekte verimlilik ve işlem hacmi sağlama biçimiyle daha iyi örtüşüyor. Bu avantaj, özellikle kontrol noktası oluşturma, veri kümesi taşıma ve paralel işlem hatlarının paylaşımlı depolama sistemleri üzerinde sürekli baskı oluşturabildiği yapay zeka iş yüklerinde daha da önem kazanır.
2. Meta Veriler Giderek Ayrı veya Dağıtılmış Kontrol Servisleri Tarafından İşleniyor
Geleneksel bir POSIX ortamında, depolama sistemleri genellikle hem dosya meta verilerini hem de dosya içeriklerini birbirine yakın şekillerde yönetir. Hiper ölçekli bulut platformları, meta veri hizmetlerini kapasite depolamasından ayırarak bunu değiştirdi; izleme ve koordinasyonun büyük bir kısmını disklerin üzerinde bırakmak yerine, daha hızlı ve ölçeklenebilir kontrol katmanlarına taşıdı.
Google Cloud'un Colossus'u bu işin büyük bir kısmını bellekte yerleşik hizmetlere kaydırırken, Meta'nın Tectonic'i ise meta verileri -dağıtılmış bir dosya sistemi modeli içinde- yatay olarak ölçeklenebilir bir anahtar-değer deposunda çalışan durumsuz mikro hizmetlere ayırır. Sonuç olarak, altta yatan sabit diskler üzerindeki yapısal yük azalır ve bu disklerin büyük ölçekte yoğun ve verimli kapasite sunma fırsatı artar.
3. Silme Kodlaması Dağıtılmış Dayanıklılığı Güçlendiriyor
Üçüncü bir ilke ise, büyük ölçekli depolama sistemlerini daha dayanıklı ve verimli hale getirmek için silme kodlaması ve geniş veri dağıtımının kullanılmasıdır.
Bulut mimarileri, silme kodlaması ve geniş veri dağıtımı yoluyla bu hassasiyeti azaltır. Bu sistemler, nesneleri birçok diske dağıtarak yerel sorunlu noktaları izole edebilir, kısa süreli gecikme artışlarında veri sunmaya devam edebilir ve gerektiğinde yeniden yapılandırabilir. Bu, depolama katmanını daha dayanıklı hale getirir ve karma bulut ve yapay zeka iş yükleri altında işlem hacminin sürdürülmesine yardımcı olur.
4. Çok Katmanlı Veri Yolu
Dördüncü ilke ise verilerin kapasite ortamına ulaşmadan önce nasıl aşamalandırıldığıdır.
Öngörülemeyen uygulama trafiği ile yüksek yoğunluklu sabit disklerin en iyi şekilde işleyebildiği yapılandırılmış ortam arasındaki boşluğu kapatmak için, modern mimariler, veri alımını tamponlamak ve veri yerleşimini optimize etmek amacıyla flaş veya bellek içeren çok katmanlı bir veri yolu kullanır.
Flash katmanı, API trafiğinden ve uygulama yazma işlemlerinden kaynaklanan değişken geliş hızlarını absorbe eder. Gelen verileri depolama ortamına geçmeden önce düzenler ve organize eder; bu sayede arka plan işlemleri, verileri uzun ve ardışık geçişlerle sabit disk dizilerine yazabilir.
Özellikle veri alımı, kontrol noktası oluşturma ve veri seti aktarımının ani artışlar gösterebildiği yapay zeka iş yüklerinde, bu tamponlama rolü daha da önem kazanır çünkü hem düşük gecikmeli veri alımını hem de verimli sabit disk kullanımını korumaya yardımcı olur.
ŞEK. 1. Sabit disk merkezli depolama mimarisinin avantajlarını en üst düzeye çıkarmada geleneksel POSIX ve bulut tabanlı depolama yazılımlarının karşılaştırılması.
Birincil Depolama İçin Yeni Bir Model
Bu mimari değişimler bir araya gelerek birincil depolama alanının tanımını yeniden şekillendirdi. Tarihsel olarak, "birincil depolama" genellikle bilgisayara yakından bağlı, pahalı ve yüksek kullanılabilirliğe sahip blok veya dosya sistemlerini ifade ediyordu. Nesne depolama, eskiden daha yaygın olarak arşiv, yedekleme veya ikincil veriler için alt düzey bir depolama alanı olarak ele alınıyordu.
Günümüzde birçok bulut tabanlı mimari, birincil depolamayı daha geniş bir şekilde tanımlıyor: küresel bir nesne deposuyla eşleştirilmiş durumsuz işlem gücü. S3, Azure ve GCS gibi platformlar üzerinde oluşturulan veri gölleri, büyük ölçekli analizler, bulut uygulamaları ve yapay zeka iş akışları için giderek daha fazla kayıt sistemi görevi görüyor.
Bu modelde, birincil depolama giderek yazılım tanımlı hale geliyor; nesne hizmetleri, meta veri katmanları, flash tamponlama ve yüksek kapasiteli sabit diskler koordineli bir sistem olarak birlikte çalışıyor.
Hesaplama örnekleri genellikle daha esnek ve durumsuz olarak ele alınır; nesne katmanından veri çeker, işler ve sonuçları aynı paylaşılan ortama geri yazar.
Nesne Depolama ve Dosya Anlambiliminin Yakınsaması
Nesne depolama, son on yılda bulut mimarilerinde ve daha yakın zamanda yapay zeka iş akışlarında daha merkezi bir rol oynamaya başladıkça, bir başka önemli trend ortaya çıktı: yüksek performanslı, paralel dosya sistemleri.
Lustre, Weka ve VAST gibi sistemler, birbirine sıkıca bağlı iş yükleri için performansı en üst düzeye çıkarmak üzere tasarlanmıştır ve genellikle kontrol noktası oluşturma, koordinasyon ve yüksek verimli veri erişimini desteklemek için POSIX uyumlu arayüzler sunarlar.
Aynı zamanda, nesne depolama platformları da gelişmeye devam ederek küresel ölçeklenebilirliği optimize ederken, genişleyen yapay zeka ve veri yoğun iş yüklerini desteklemek için performansı da artırdı.
Büyük ölçekli bulut ve yapay zeka ortamlarında bu yaklaşımlar birbirine yakınlaşıyor. Yüksek performanslı dosya sistemleri genellikle nesne depolama arka uçlarının üzerine katmanlanır veya onlarla bütünleşir; bu sayede aktif çalışma kümesi için performans, kayıt sistemi olarak nesne depolamanın ölçeklenebilirliği ve ekonomikliğiyle birleştirilir.
Bu yakınlaşma, daha geniş bir mimari değişimi yansıtıyor: modern sistemler, dosya ve nesne arasında seçim yapmak yerine, bunları birleştiriyor. Klasörlerin, ad alanlarının ve alış familiar dosya davranışlarının kolaylığını korurken, nesne tabanlı depolamanın ölçeklenebilirlik avantajlarından da ödün vermez.
Bulut ve Yapay Zeka Altyapı Geliştiricileri İçin Çıkarımlar
Birlikte ele alındığında, bu değişimler daha geniş bir sonuca işaret ediyor: bulut ve yapay zeka mimarileri, POSIX öncelikli modellerin başlangıçta optimize etmek üzere tasarlandığı yazılım ve sistem ödünleşmelerinden farklı ödünleşmeler gerektiriyordu.
Bu ödünleşmeler, sistemlerin temelini oluşturan sabit disk filolarının kullanımını optimize edecek şekilde yazılım tasarlamanın önemini artırdı. Bu anlamda, bulut ve yapay zeka iş yükleri yalnızca depolama mimarisini değiştirmekle kalmadı; birincil depolamanın kendisini de yeniden tanımladı.
Altyapı geliştiricileri için çıkarılacak ders açık: modern sistemler için tasarım yapmak, birincil depolamanın yerel işletim sistemi dosya ağacına sorunsuz bir şekilde eşleşmesi gerektiği varsayımının ötesine geçmeyi gerektirir. Bu, yapay zekanın büyük ölçekte uygulanmasının ekonomik, fiziksel ve iş yükü gerçekleriyle uyumlu yazılım ve erişim modelleri seçmek anlamına gelir.
Bu konuda başarılı olan kuruluşlar, daha yüksek GPU kullanımı, daha iyi çıkarım ekonomisi ve daha az performans darboğazı ile yapay zeka stratejilerini daha verimli bir şekilde uygulama konusunda daha iyi bir konumda olacaklardır.
Dünyanın en büyük yapay zeka ve bulut altyapı geliştiricileri için birincil depolama çözümü sağlayan sabit disk yenilikleri hakkında daha fazla bilgi edinin.
Kaynaklar
1. IDC Datasphere ve IDC Storagesphere
2. AWS re:Invent 2025, Andy Warfield açılış konuşması: S3, 500 trilyondan fazla nesneyi depoluyor, saniyede 200 milyon isteğe hizmet veriyor ve yılda 1 katrilyondan fazla isteği işliyor.